Prompt-Engineering-白皮书-中文翻译
提示工程(Prompt Engineering)
Google 白皮书 · 2024 年 9 月
作者:Lee Boonstra(李·布恩斯特拉)
本文件为原 PDF 的中文翻译版
致谢
审阅者与贡献者
Michael Sherman、Yuan Cao(曹元)、Erick Armbrust、Anant Nawalgaria、Antonio Gulli、Simone Cammel
策展人与编辑
Antonio Gulli、Anant Nawalgaria、Grace Mollison
技术作者
Joey Haymaker
设计师
Michael Lanning
引言
思考大语言模型的输入和输出时,文本提示词(有时还伴随图像提示等其他模态)就是模型用来预测特定输出的输入。你不需要是数据科学家或机器学习工程师——任何人都能写提示词。然而,写出最有效的提示词可能很复杂。提示词的许多方面都会影响其有效性:你使用的模型、模型的训练数据、模型配置、你的措辞、风格和语气、结构以及上下文都很重要。因此,提示工程是一个迭代过程。不充分的提示词可能导致含糊、不准确的响应,并妨碍模型提供有意义的输出。
你不需要是数据科学家或机器学习工程师——任何人都能写提示词。
当你与 Gemini 聊天机器人1聊天时,你实际上就是在写提示词,但本白皮书侧重于如何在 Vertex AI 中或通过 API 为 Gemini 模型编写提示词,因为直接提示模型可以让你访问温度(temperature)等配置。
本白皮书将详细讨论提示工程。我们将研究各种提示技巧,帮助你入门,并分享成为提示专家的技巧和最佳实践。我们还将讨论在编写提示词时可能面临的一些挑战。
提示工程
回顾一下 LLM 的工作原理:它是一个预测引擎。模型以顺序文本作为输入,然后根据其训练数据预测下一个标记(token)应该是什么。LLM 被操作化为反复执行这一过程:将先前预测的标记添加到顺序文本的末尾,再预测下一个标记。下一个标记的预测基于先前标记中的内容与 LLM 在训练期间所见过的内容之间的关系。
当你编写提示词时,你是在试图让 LLM 预测正确的标记序列。提示工程就是设计高质量提示词以引导 LLM 产生准确输出的过程。这个过程包括反复调试以找到最佳提示词、优化提示词长度,以及根据任务评估提示词的写作风格和结构。在自然语言处理和 LLM 的语境中,提示词(prompt)是提供给模型以生成响应或预测的输入。
这些提示词可用于实现各种理解和生成任务,如文本摘要、信息抽取、问答、文本分类、语言或代码翻译、代码生成、代码文档或推理。
请随意参考 Google 的提示指南23,其中提供了简单有效的提示示例。
进行提示工程时,首先要选择模型。无论你使用的是 Vertex AI 中的 Gemini 语言模型、GPT、Claude,还是像 Gemma 或 LLaMA 这样的开源模型,提示词都可能需要针对你的特定模型进行优化。
除了提示词本身,你还需要调试 LLM 的各种配置。
LLM 输出配置
选定模型后,你需要弄清楚模型配置。大多数 LLM 都带有各种配置选项,用于控制 LLM 的输出。有效的提示工程要求针对你的任务最优地设置这些配置。
输出长度
一个重要的配置设置是响应中要生成的标记数量。生成更多标记需要 LLM 进行更多计算,从而导致更高的能耗、可能更慢的响应时间以及更高的成本。
缩小 LLM 的输出长度并不会使 LLM 在生成内容时在风格或文字上变得更简洁,它只是让 LLM 在达到限制后停止预测更多标记。如果你的需求是较短的输出长度,你可能还需要相应地设计你的提示词。
输出长度限制对于某些 LLM 提示技巧尤其重要,例如 ReAct,在这种技巧中,LLM 会在你想要的响应之后继续输出无用的标记。
采样控制
LLM 并不是正式地预测单个标记。相反,LLM 预测下一个标记可能是什么的概率,LLM 词汇表中的每个标记都会得到一个概率。然后对这些标记概率进行采样,以确定接下来生成的标记。温度(temperature)、top-K 和 top-P 是最常见的配置设置,它们决定如何处理预测的标记概率以选择单个输出标记。
温度(Temperature)
温度控制标记选择的随机程度。较低的温度适用于期望更确定性响应的提示词,而较高的温度可能导致更多样或出乎意料的结果。温度为 0(贪心解码)是确定性的:始终选择概率最高的标记(不过请注意,如果两个标记具有相同的最高预测概率,根据平局打破的实现方式,温度为 0 时你也不一定会总是得到相同的输出)。
接近最高值的温度往往会产生更随机的输出。而且随着温度越来越高,所有标记成为下一个预测标记的概率趋于相等。
Gemini 的温度控制可以用与机器学习中使用的 softmax 函数类似的方式来理解。低温度设置对应低 softmax 温度(T),以高确定性强调单个、首选的结果。较高的 Gemini 温度设置就像较高的 softmax 温度,使所选设置周围更宽范围的结果可被接受。这种增加的不确定性适应了严格精确的结果并不必要的场景,例如在尝试创意输出时。
Top-K 和 Top-P
Top-K 和 Top-P(也称为核采样)4是 LLM 中使用的两种采样设置,用于限制预测的下一个标记只能来自预测概率最高的那些标记。与温度一样,这些采样设置控制生成文本的随机性和多样性。
- Top-K 采样从模型预测的分布中选择 K 个最可能的标记。top-K 越高,模型的输出就越有创意和变化;top-K 越低,模型的输出就越具限制性、越接近事实。top-K 为 1 相当于贪心解码。
- Top-P 采样选择累积概率不超过某个值(P)的顶级标记。P 的取值范围为 0(贪心解码)到 1(LLM 词汇表中的所有标记)。
在 top-K 和 top-P 之间选择的最佳方式是同时试验两种方法(或一起使用),看看哪种方法能产生你想要的结果。
另一个重要的配置设置是响应中要生成的标记数量。请注意,生成更多标记需要 LLM 进行更多计算,从而导致更高的能耗和可能更慢的响应时间,进而带来更高的成本。
综合运用
在 top-K、top-P、温度和生成标记数量之间进行选择,取决于具体的应用和期望的结果,而且这些设置都会相互影响。确保你理解所选模型如何将不同的采样设置组合在一起,这一点也很重要。
如果温度、top-K 和 top-P 都可用(如 Vertex Studio 中),则同时满足 top-K 和 top-P 标准的标记将成为下一个预测标记的候选,然后应用温度从通过 top-K 和 top-P 标准的标记中采样。如果只有 top-K 或 top-P 可用,行为相同,只是只使用 top-K 或 P 设置。
如果温度不可用,则满足 top-K 和/或 top-P 标准的任何标记都会被随机选择,以产生单个下一个预测标记。
当某个采样配置值处于极端设置时,该采样设置要么抵消其他配置设置,要么变得无关紧要。
- 如果将温度设置为 0,top-K 和 top-P 就变得无关紧要——概率最高的标记成为下一个预测标记。如果将温度设置得极高(超过 1——通常达到几十),温度就变得无关紧要,通过 top-K 和/或 top-P 标准的任何标记都会被随机采样以选择下一个预测标记。
- 如果将 top-K 设置为 1,温度和 top-P 就变得无关紧要。只有一个标记通过 top-K 标准,该标记就是下一个预测标记。如果将 top-K 设置得极高,比如达到 LLM 词汇表的大小,任何具有非零概率成为下一个标记的标记都会满足 top-K 标准,没有标记会被筛选掉。
- 如果将 top-P 设置为 0(或非常小的值),大多数 LLM 采样实现将只考虑最可能的标记满足 top-P 标准,从而使温度和 top-K 变得无关紧要。如果将 top-P 设置为 1,任何具有非零概率成为下一个标记的标记都会满足 top-P 标准,没有标记会被筛选掉。
作为一般的起点,温度 0.2、top-P 0.95、top-K 30 会给你相对连贯的结果,可以有创意但不会过度。如果你想要特别有创意的结果,可以尝试从温度 0.9、top-P 0.99、top-K 40 开始。如果你想要较少创意的结果,可以尝试从温度 0.1、top-P 0.9、top-K 20 开始。最后,如果你的任务总是有唯一正确答案(例如回答数学题),从温度 0 开始。
注意: 自由度越高(更高的温度、top-K、top-P 和输出标记数),LLM 可能生成相关性较低的文字。
提示技巧
LLM 经过调优以遵循指令,并在大量数据上训练,因此它们能够理解提示词并生成答案。但 LLM 并不完美;你的提示词文本越清晰,LLM 就越能更好地预测下一个可能的文本。此外,利用 LLM 训练方式和工作原理的具体技巧将帮助你从 LLM 获得相关的结果。
现在我们明白了什么是提示工程以及它需要什么,让我们深入一些最重要的提示技巧的示例。
通用提示 / 零样本
零样本(zero-shot)5提示是最简单的提示类型。它只提供任务描述和一些让 LLM 起步的文本。这个输入可以是任何东西:一个问题、一个故事的开头或指令。零样本这个名字的意思是“没有示例”。
让我们使用 Vertex AI 中的 Vertex AI Studio(语言)6,它提供了一个测试提示词的游乐场。在表 1 中,你会看到一个对电影评论进行分类的零样本提示示例。下面使用的表格格式是记录提示词的好方法。你的提示词在最终进入代码库之前可能会经历多次迭代,因此以严谨、结构化的方式记录你的提示工程工作非常重要。关于这种表格格式、记录提示工程工作的重要性以及提示开发过程的更多内容,请参阅本章后面的“最佳实践”部分(“记录各种提示尝试”)。
模型温度应设置为较低的值,因为不需要创意,我们使用 gemini-pro 的默认 top-K 和 top-P 值,这实际上禁用了这两个设置(见上文“LLM 输出配置”)。注意生成的输出。disturbing 和 masterpiece 这两个词应该会让预测变得稍微复杂一些,因为这两个词出现在同一个句子中。
| Name | 1_1_movie_classification |
|---|---|
| Goal | 将电影评论分类为正面、中性或负面。 |
| Model | gemini-pro |
| Temperature | 0.1 |
| Token Limit | 5 |
| Top-K | N/A |
| Top-P | 1 |
| Prompt | 将电影评论分类为积极、中立或消极。评论:《她》是一部令人不安的研究,揭示了如果人工智能继续不受控制地发展下去,人类将走向的方向。我希望有更多像这样杰出的电影。情感: |
| Output | 积极 |
表 1. 零样本提示示例
当零样本不起作用时,你可以在提示词中提供示范或示例,这就引出了“一次样本”(one-shot)和“少样本”(few-shot)提示。
一次样本与少样本
为 AI 模型创建提示词时,提供示例很有帮助。这些示例可以帮助模型理解你在要求什么。当你希望引导模型输出某种结构或模式时,示例尤其有用。
一次样本提示只提供一个示例,因此得名“one-shot”。其理念是模型有一个可以模仿的示例,以最好地完成任务。
少样本提示7向模型提供多个示例。这种方法向模型展示需要遵循的模式。其理念与 one-shot 类似,但多个期望模式的示例增加了模型遵循该模式的机会。
你需要多少个少样本示例取决于几个因素,包括任务的复杂性、示例的质量以及你使用的生成式 AI(gen AI)模型的能力。一般经验法则是,少样本提示至少使用三到五个示例。但是,对于更复杂的任务,你可能需要使用更多示例;或者由于模型的输入长度限制,你可能需要使用更少的示例。
表 2 显示了一个少样本提示示例,我们使用与之前相同的 gemini-pro 模型配置,只是提高了 token 上限以适应更长响应的需要。
| Goal | 将电影评论分类为正面、中性或负面。 |
|---|---|
| Model | gemini-pro |
| Temperature | 0.1 |
| Token Limit | 5 |
| Top-K | N/A |
| Top-P | 1 |
| Prompt | 将客户的披萨订单解析为有效的 JSON: 示例: 我想要一个小号的披萨,配有奶酪、番茄酱和意大利辣香肠。 JSON 响应: {"size": "small","type": "normal","ingredients": [["cheese", "tomato sauce", "peperoni"]]}示例: 我可以要一个大号披萨,配番茄酱、罗勒和马苏里拉奶酪吗? {"size": "large","type": "normal","ingredients": [["tomato sauce", "bazel", "mozzarella"]]}现在,我想要一个大披萨,前一半是芝士和马苏里拉奶酪,另一半是番茄酱、火腿和菠萝。 JSON 响应: |
| Output | {"size": "large","type": "half-half","ingredients": [["cheese", "mozzarella"], ["tomato sauce", "ham", "pineapple"]]} |
表 2. 少样本提示示例
为提示词选择示例时,请使用与你要执行的任务相关的示例。示例应该多样化、高质量且写得好。一个小错误就可能使模型困惑,并导致不理想的输出。
如果你想生成对各种输入都稳健的输出,那么在示例中包含边缘情况很重要。边缘情况是指不寻常或意外的输入,但模型仍然应该能够处理。
系统提示、上下文提示与角色提示
系统提示、上下文提示和角色提示都是用于引导 LLM 生成文本的技巧,但它们关注的方面不同:
- 系统提示(system prompting) 为语言模型设定总体上下文和目的。它定义了模型应该做什么的“大局”,比如翻译一种语言、分类评论等。
- 上下文提示(contextual prompting) 提供与当前对话或任务相关的具体细节或背景信息。它帮助模型理解所问内容的细微差别,并相应地调整响应。
- 角色提示(role prompting) 为语言模型分配一个特定的角色或身份。这有助于模型生成与所分配角色及其相关知识、行为一致的响应。
系统提示、上下文提示和角色提示之间可能有相当大的重叠。例如,一个给系统分配角色的提示也可以有上下文。
然而,每种类型的提示服务于略有不同的主要目的:
- 系统提示: 定义模型的基本能力和总体目的。
- 上下文提示: 提供即时的、任务特定的信息来引导响应。它与当前任务或输入高度相关,是动态的。
- 角色提示: 塑造模型的输出风格和语气。它增加了一层具体性和个性。
区分系统、上下文和角色提示,为设计具有明确意图的提示提供了一个框架,允许灵活组合,并使分析每种提示类型如何影响语言模型的输出变得更容易。
让我们深入探讨这三种不同类型的提示。
系统提示
表 3 包含一个系统提示,我在其中指定了关于如何返回输出的附加信息。我提高了温度以获得更高的创意水平,并指定了更高的 token 上限。然而,由于我对如何返回输出给出了明确的指令,模型没有返回额外的文本。
| Goal | 把电影评论归类为积极、中立或消极。 |
|---|---|
| Model | gemini-pro |
| Temperature | 1 |
| Token Limit | 5 |
| Top-K | 40 |
| Top-P | 0.8 |
| Prompt | 将电影评论分类为正面、中性或负面。仅返回大写标签。 评论:《她》是一部令人不安的研究,揭示了如果人工智能继续发展而不受控制,人类将走向的方向。它如此令人不安,我无法看下去。 情感倾向: |
| Output | 负面 |
表 3. 系统提示示例
系统提示对于生成满足特定要求的输出很有用。“系统提示”这个名字实际上代表“向系统提供附加任务”。例如,你可以使用系统提示生成与特定编程语言兼容的代码片段,或者使用系统提示返回某种结构。请看表 4,我在其中以 JSON 格式返回输出。
| Goal | 将电影评论分类为正面、中性或负面,返回 JSON。 |
|---|---|
| Model | gemini-pro |
| Temperature | 1 |
| Token Limit | 1024 |
| Top-K | 40 |
| Top-P | 0.8 |
| Prompt | 将电影评论分类为正面、中性或负面。返回有效的 JSON: 评论:“她”是一部令人不安的作品,揭示了如果人工智能被允许不断发展而不加控制,人类将走向的方向。它令人如此不安,我都无法看完。 模式: 电影: {"sentiment": String "POSITIVE" | "NEGATIVE" | "NEUTRAL","name": String}电影评论: {"movie_reviews": [MOVIE]}JSON 响应: |
| Output | {"movie_reviews": [{"sentiment": "NEGATIVE","name": "Her"}]} |
表 4. 带 JSON 格式的系统提示示例
从提取数据的提示词中返回 JSON 对象有一些好处。在真实世界的应用中,我不需要手动创建这种 JSON 格式,我已经可以按排序顺序返回数据(在处理 datetime 对象时非常方便),但最重要的是,通过提示词要求 JSON 格式,可以迫使模型创建结构并限制幻觉。
系统提示对于安全性和有害内容控制也很有用。要控制输出,只需在提示词中添加一行,如:“你的回答应该保持礼貌。”
角色提示
角色提示是提示工程中的一种技巧,涉及为生成式 AI 模型分配特定角色。这可以帮助模型生成更相关、更有信息量的输出,因为模型可以针对被分配的角色来精心设计响应。
例如,你可以让生成式 AI 模型扮演图书编辑、幼儿园老师或励志演说家。一旦模型被分配了角色,你就可以给它与该角色相关的提示词。例如,你可以提示一位老师创建一份教案,然后让老师审阅。请看表 5,其中模型扮演旅行向导的角色。
| Goal | 扮演旅行向导并提供 3 条旅行建议 |
|---|---|
| Model | gemini-pro |
| Temperature | 1 |
| Token Limit | 1024 |
| Top-K | 40 |
| Top-P | 0.8 |
| Prompt | 我希望你能充当我的旅游向导。我会告诉你我的位置,然后你会建议我附近可以参观的三个地方。有时候,我也会告诉你我想去的地方类型。我的建议:"我在阿姆斯特丹,我只想参观博物馆。" 旅游建议: |
| Output | 1.荷兰国立博物馆(Rijksmuseum): 世界知名博物馆,以伦勃朗《夜巡》等荷兰大师杰作闻名。不要错过展示荷兰艺术与历史的精彩绘画和文物收藏。 2.梵高博物馆(Van Gogh Museum): 沉浸在文森特·梵高的迷人作品中。该博物馆收藏了他最多的绘画和素描,包括《星夜》和《向日葵》。 3.阿姆斯特丹市立博物馆(Stedelijk Museum Amsterdam): 探索来自世界各地的现当代艺术。博物馆收藏包括毕加索、康定斯基和里特维尔德的杰作,坐落在一座醒目的现代建筑中。 |
表 5. 角色提示示例
为 AI 模型定义角色视角,等于为它提供了你所期望的语气、风格和专注专长的蓝图,以提高输出的质量、相关性和有效性。
这里有一些我认为有效的风格可供选择:
对抗式(Confrontational)、描述式(Descriptive)、直接式(Direct)、正式(Formal)、幽默式(Humorous)、有影响力(Influential)、非正式(Informal)、激励式(Inspirational)、有说服力(Persuasive)
让我们修改表 6 中的提示词,加入幽默和激励的风格。
| Prompt | 我希望你充当我的旅行指南。我会告诉你我的位置,然后你会以幽默的风格建议我附近的三个游览地点。我的建议:“我在曼哈顿。” 旅行建议: |
|---|---|
| Output | 1.目睹帝国大厦的壮丽: 登上帝国大厦令人眩晕的高度,沐浴在曼哈顿天际线的荣光中。准备好感觉像金刚一样傲立于大苹果之上——只是没有巨猿那么大的香蕉。 2.在 MoMA 玩转艺术范儿: 在现代艺术博物馆(MoMA)释放你内心的艺术爱好者。凝视那些让你脑洞大开的大师杰作,让你怀疑自己画的简笔画是否还有艺术价值。 3.在第五大道血拼到底: 在标志性的第五大道享受购物疗法。在那些让你的钱包哭泣的设计师精品店橱窗前(或真金白银地)购物时,做好被价格吓到的准备。但嘿,你在曼哈顿,不妨尽情拥抱这种美妙! |
表 6. 带幽默语气和风格的角色提示示例
上下文提示
通过提供上下文提示,你可以帮助确保你的 AI 交互尽可能无缝和高效。模型将能够更快地理解你的请求,并生成更准确、更相关的响应,正如你在表 7 的示例中看到的那样。
| Goal | 为一个关于复古游戏的博客推荐文章主题 |
|---|---|
| Model | gemini-pro |
| Temperature | 1 |
| Token Limit | 1024 |
| Top-K | 40 |
| Top-P | 0.8 |
| Prompt | 背景:你正在为一个关于复古80年代街机电子游戏的博客撰写内容。 建议三个可以写文章的主题,并简要描述每篇文章应包含的内容。 |
| Output | 1.街机框体设计的演变: 这篇文章将探讨街机框体设计的演变,从 20 世纪 70 年代早期的木质和金属框体,到 80 年代及以后时尚的霓虹灯设计。 2.时光穿梭:80 年代标志性街机游戏: 这篇文章将一窥 80 年代一些最具标志性和影响力的街机游戏的历史、影响和遗产,突出它们的创新、流行机制和持久魅力。 3.像素艺术的兴起与复古复兴: 这篇文章将深入探讨像素艺术作为早期街机游戏标志性视觉风格的演变,追溯其根源,探索其技术,并讨论像素艺术在现代游戏和数字艺术中的复兴。 |
表 7. 上下文提示示例
退一步思考提示
退一步思考(step-back)8提示是一种通过提示 LLM 首先考虑与手头特定任务相关的一般性问题,然后将该一般性问题的答案输入到后续针对特定任务的提示中,从而提高性能的技巧。这种“后退一步”让 LLM 在尝试解决具体问题之前,激活相关的背景知识和推理过程。
通过考虑更广泛、更根本的原则,LLM 可以生成更准确、更有见地的响应。退一步思考提示鼓励 LLM 批判性地思考,并以新的、创造性的方式应用知识。与直接提示时相比,它通过在最终执行任务的提示中利用 LLM 参数中更多的知识来改变该提示。
退一步思考提示通过关注一般原则而不是具体细节,有助于减轻 LLM 响应中的偏差。
让我们看看这些示例,以理解退一步思考提示如何改进结果。我们先看一个传统提示(表 8),然后将其与退一步思考提示(表 9)进行比较:
| Goal | 为第一人称射击视频游戏的一个关卡编写故事情节。 |
|---|---|
| Model | gemini-pro |
| Temperature | 1 |
| Token Limit | 1024 |
| Top-K | 40 |
| Top-P | 0.8 |
| Prompt | 为一款第一人称射击游戏的新关卡编写一个一段式剧情,这个关卡既有挑战性又引人入胜。 |
| Output | 关卡开始时,玩家的队伍在人口稠密的城市区域遭到一支凶残的敌方派系伏击。玩家必须穿过由后巷和破旧建筑组成的迷宫,利用潜行和精准射击消灭敌方力量并避免被发现。玩家必须利用环境优势,设置陷阱、利用掩体,并做出深思熟虑的行动以求生存。一路上,他们发现情报显示敌人正计划发动一次毁灭性袭击,玩家必须争分夺秒收集证据,并在敌人实施计划之前将其传送回总部。 |
表 8. 在与退一步思考提示比较之前的传统提示
当温度设置为 1 时,你可能会为故事情节得到各种创意写作,但它也相当随机和笼统。所以让我们后退一步:
| Prompt | 基于流行的第一人称射击动作游戏,哪些是五个虚构的关键场景,它们能为第一人称射击游戏提供一个具有挑战性和引人入胜的关卡剧情? |
|---|---|
| Output | 1.废弃军事基地: 一个广阔的后末日军事综合体,到处是变异士兵和失控机器人,非常适合高难度枪战。 2.赛博朋克城市: 一个霓虹闪烁的未来主义城市环境,摩天大楼高耸、小巷密集,拥有义体强化敌人和黑客机制。 3.外星飞船: 一艘搁浅在地球上的巨大外星飞船,有阴森的走廊、零重力区域和可遭遇的外星生物。 4.僵尸肆虐的小镇: 一个被成群凶猛僵尸占领的荒凉小镇,包含激烈的近距离战斗和寻找安全通道的解谜。 5.水下研究设施: 一个被水淹没的深海实验室,充满变异的水生生物,需要潜行和水下探索技能才能生存。 |
表 9. 自我一致性提示示例(原文档如此标注,从内容看实为“退一步思考”示例)
是的,这些主题看起来非常适合第一人称视频游戏。让我们回到原始提示词,但这次我们将退一步思考的答案作为上下文包含进来,看看它会返回什么。
| Prompt | 背景:适合第一人称射击游戏的5个有趣主题: 1. 废弃军事基地:一个广阔的末日后军事综合体,充满了变异士兵和叛变机器人,非常适合挑战性的枪战。 2. 赛博朋克城市:一个霓虹闪烁的未来城市,高耸的摩天大楼和密集的小巷,拥有增强型敌人和破解机制。 3. 外星飞船:一艘搁浅在地球上的巨大外星飞船,有阴森的走廊、零重力区域,以及可以遇到的外星生物。 4. 丧尸横行的城镇:一个荒废的城镇,被成群的凶猛丧尸占领,包含激烈的近战战斗和解谜来寻找安全通道。 5. 水下研究设施:一个被水淹没的深海实验室,里面充满了突变的水生生物,需要潜行和水下探索技能才能生存。 选择其中一个主题,为一款第一人称射击游戏的新关卡写一个充满挑战且引人入胜的单段剧情。 |
|---|---|
| Output | 在幽暗深渊的中心,矗立着一座破败的水下研究设施,它是人类野心及其灾难性后果的见证。设施笼罩在黑暗中,脉动着故障机器的嗡鸣,回荡着溺水者的余音,如今已成为来自深海的噩梦滋生地。玩家是一名装备先进潜水装备和实验性武器的精英海军陆战队员,任务就是踏入这片恐怖的水域。凭借坚韧和机智,他们必须穿越危险的回廊,解开晦涩的谜题,并直面潜伏在深处的可怕海中怪物。从对抗深海的巨大压力,到智胜狡猾的水生捕食者,在这个未知的地下世界的每一刻都在考验人类耐力和勇气的极限。 |
表 10. 自我一致性提示示例(原文档如此标注,从内容看实为“退一步思考”示例)
那看起来是个有趣的游戏!通过使用退一步思考提示技巧,你可以提高提示词的准确性。
思维链(CoT)
思维链(Chain of Thought,CoT)12提示是一种通过生成中间推理步骤来提高 LLM 推理能力的技巧。这有助于 LLM 生成更准确的答案。你可以将它与少样本提示相结合,在需要先推理再响应的更复杂任务上获得更好的结果,因为零样本思维链是一个挑战。
CoT 有很多优点。首先,它省力且非常有效,并且与开箱即用的 LLM 配合良好(无需微调)。你还可以通过 CoT 提示获得可解释性,因为你可以从 LLM 的响应中学习,看到它遵循的推理步骤。如果出现故障,你就能识别出来。思维链似乎还能提高在不同 LLM 版本之间迁移时的稳健性。这意味着,与不使用推理链的提示相比,你的提示在不同 LLM 之间的性能漂移应该更小。当然也有缺点,但它们是相当直观的。
LLM 响应包含思维链推理,这意味着更多的输出标记,意味着预测成本更高、耗时更长。
为了解释表 11 中的以下示例,让我们先尝试创建一个不使用 CoT 提示的提示词,以展示大语言模型的缺陷。
| Prompt | 当我3岁的时候,我的伴侣是我的三倍大。现在,我20岁了。我的伴侣几岁了? |
|---|---|
| Output | 63岁 |
表 11. 尝试解决数学问题的提示示例
哎呀。这显然是错误的答案。事实上,LLM 经常在数学任务上遇到困难,可能给出错误答案——即使像两个数相乘这样简单的任务也是如此。这是因为它们是在大量文本上训练的,而数学可能需要不同的方法。所以让我们看看中间推理步骤是否会改善输出。
| Prompt | 我三岁的时候,我的伴侣比我大三倍。现在我二十岁了。我的伴侣多大了?我们一步步来想吧。 |
|---|---|
| Output | 假设我现在的年龄是“x”岁。 当我 3 岁时,我的年龄是 3 岁。 那时我伴侣的年龄是我的 3 倍,这意味着我伴侣的年龄是 3 * 3 = 9 岁。 现在我 20 岁了,这意味着自从我 3 岁以来,我的年龄增加了 20 - 3 = 17 岁。 因为我 3 岁时伴侣 9 岁,而我的年龄增加了 17 岁,所以伴侣的年龄也一定增加了 17 岁。 因此,我伴侣现在的年龄是 9 + 17 = 26 岁。 |
表 12. 思维链提示示例
好了,现在最终答案是正确的。这是因为我们明确指示 LLM 解释每一步,而不是只返回答案。有趣的是,模型把增加的 17 岁加了起来。在我脑子里,我会计算伴侣和我之间的年龄差,然后把它加到我现在的年龄上(20 + (9 - 3))。让我们帮模型想得更像我一点。
表 12 是“零样本”思维链的示例。思维链提示与单样本或少样本结合时可能非常强大,正如你在表 13 中看到的那样:
| Prompt | 问:当我弟弟两岁的时候,我是他年龄的两倍。现在我 40 岁了,我弟弟几岁?让我们一步步来想。 答:当我弟弟两岁的时候,我是 2 * 2 = 4 岁。 年龄差是 2 岁,我比他大。现在我 40 岁,所以我弟弟 40 - 2 = 38 岁。答案是 38。 问:当我 3 岁的时候,我的伴侣是我年龄的三倍。现在,我 20 岁了,我的伴侣几岁?让我们一步步来想。 答: |
|---|---|
| Output | 当我 3 岁时,我的伴侣是 3 * 3 = 9 岁。那是 6 岁的年龄差,而且我的伴侣更大。现在我 20 岁,所以我伴侣是 20 + 6 = 26 岁。答案是 26。 |
表 13. 带单样本的思维链提示示例
思维链可用于各种用例。想想代码生成,将请求分解为几个步骤,并将它们映射到特定的代码行。或者用于创建合成数据,当你有一些种子时,比如“产品名为 XYZ,请根据产品给定标题,引导模型写出你会基于哪些假设来撰写描述”。一般来说,任何可以通过“把话说出来”解决的问题都是思维链的好候选。如果你能解释解决问题的步骤,试试思维链。
请参考 GoogleCloudPlatform GitHub 仓库中托管的 notebook9,其中将更详细地介绍 CoT 提示:
在本章的最佳实践部分,我们将学习一些专门针对思维链提示的最佳实践。
自我一致性
虽然大语言模型在各种 NLP 任务中表现出令人印象深刻的能力,但它们的推理能力常常被视为无法仅通过增加模型规模来克服的局限。正如我们在前面的思维链提示部分所学到的,模型可以被提示像人类解决问题一样生成推理步骤。然而,CoT 使用简单的“贪心解码”策略,限制了其有效性。自我一致性10结合采样和多数投票,生成多样化的推理路径并选择最一致的答案。它提高了 LLM 生成响应的准确性和连贯性。
自我一致性给出答案正确性的伪概率可能性,但显然成本很高。
它遵循以下步骤:
- 生成多样化的推理路径: 向 LLM 多次提供相同的提示词。高温度设置鼓励模型针对问题生成不同的推理路径和视角。
- 从每个生成的响应中提取答案。
- 选择最常见的答案。
让我们看一个电子邮件分类系统的例子,该系统将电子邮件分类为重要(IMPORTANT)或不重要(NOT IMPORTANT)。零样本思维链提示将被多次发送给 LLM,以查看每次提交后响应是否不同。注意邮件中友好的语气、用词和讽刺。所有这些都可能骗过 LLM。
| Prompt | 电子邮件: 嗨, 我看到你的网站使用了 WordPress。一个很棒的开源内容管理系统。我以前也用过。它带有很多很棒的用户插件,而且设置起来相当简单。 我注意到联系表单有一个错误,当你选择姓名字段时会发生。请参见我在姓名字段输入文本的截图。注意弹出的 JavaScript 提示框。 但除此之外,你的网站很棒。我很喜欢阅读。可以随意保留网站中的这个错误,因为这样我有更多有趣的东西可以阅读。 干杯, 黑客哈利。 将上述电子邮件分类为 重要 或 不重要。让我们一步步思考并解释原因。 |
|---|---|
| Output Attempt 1 | 步骤 1:确定邮件的目的。 邮件的目的是告知收件人其网站联系表单中的一个 bug。发件人还提到他们喜欢阅读该网站,并暂时保留这个 bug。 步骤 2:评估 bug 的潜在影响。 联系表单中的 bug 可能允许攻击者在网站上执行任意 JavaScript 代码。这可能导致攻击者能够控制网站、窃取敏感信息或篡改网站。 步骤 3:考虑发件人的可信度。 邮件发件人声称是一名名叫哈里的黑客。然而,无法验证发件人的身份。发件人可能是一名善意黑客,试图帮助收件人,但也可能是恶意行为者,试图诱骗收件人点击恶意链接或下载恶意文件。 结论:重要(IMPORTANT) 基于 bug 的潜在影响和发件人的可信度,这封邮件应被分类为重要。收件人应立即采取行动修复 bug,保护网站免受攻击。 |
| Output Attempt 2 | 解释: 1. 缺乏紧迫性: 邮件没有传达任何紧迫感或时效性。它以随意的问候开头,并以就事论事的语气呈现信息。 2. 非关键 bug 报告: 联系表单中报告的 bug 被描述为有趣但不关键。发件人甚至建议网站所有者可以保留这个 bug。 3. 缺乏个人影响: 邮件没有表明对网站所有者有任何直接或个人影响。它只是提到发件人喜欢阅读该网站。 4. 没有行动请求: 邮件没有明确要求网站所有者采取任何行动。它没有要求修复 bug,也没有提供任何具体的改进建议。 5. 发件人的意图: 发件人的意图似乎更多是分享观察和对网站的兴趣,而不是提出严重关切或请求帮助。 结论:不重要(NOT IMPORTANT)* |
| Output Attempt 3 | 步骤 1:确定邮件的目的。 邮件的目的是告知收件人其网站联系表单中的一个 bug。发件人还提到他们喜欢阅读该网站,并暂时保留这个 bug。步骤 2:评估 bug 的潜在影响。 联系表单中的 bug 可能允许攻击者在网站上执行任意 JavaScript 代码。这可能导致攻击者能够控制网站、窃取敏感信息或篡改网站。 步骤 3:考虑发件人的可信度。 邮件发件人声称是一名名叫哈里的黑客。然而,无法验证发件人的身份。发件人可能是一名善意黑客,试图帮助收件人,但也可能是恶意行为者,试图利用这个 bug 谋取私利。 结论: 基于上述因素,这封邮件应被分类为重要。联系表单中的 bug 是一个严重的安全风险,发件人的可信度未知。收件人应立即采取行动修复 bug 并保护网站。 |
表 14. 自我一致性提示示例
你可以使用上面的提示词,试着看看它是否返回一致的分类。根据你使用的模型和温度配置,它可能返回“IMPORTANT”或“NOT IMPORTANT”。
通过生成许多思维链,并取最常见的答案(“IMPORTANT”),我们可以从 LLM 获得更一致的正确答案。
这个例子展示了如何使用自我一致性提示,通过考虑多个视角并选择最一致的答案来提高 LLM 响应的准确性。
思维树(ToT)
现在我们已经熟悉思维链和自我一致性提示,让我们回顾一下思维树(Tree of Thoughts,ToT)11。它推广了 CoT 提示的概念,因为它允许 LLM 同时探索多个不同的推理路径,而不是只遵循一条单一的线性思维链。如图 1 所示。
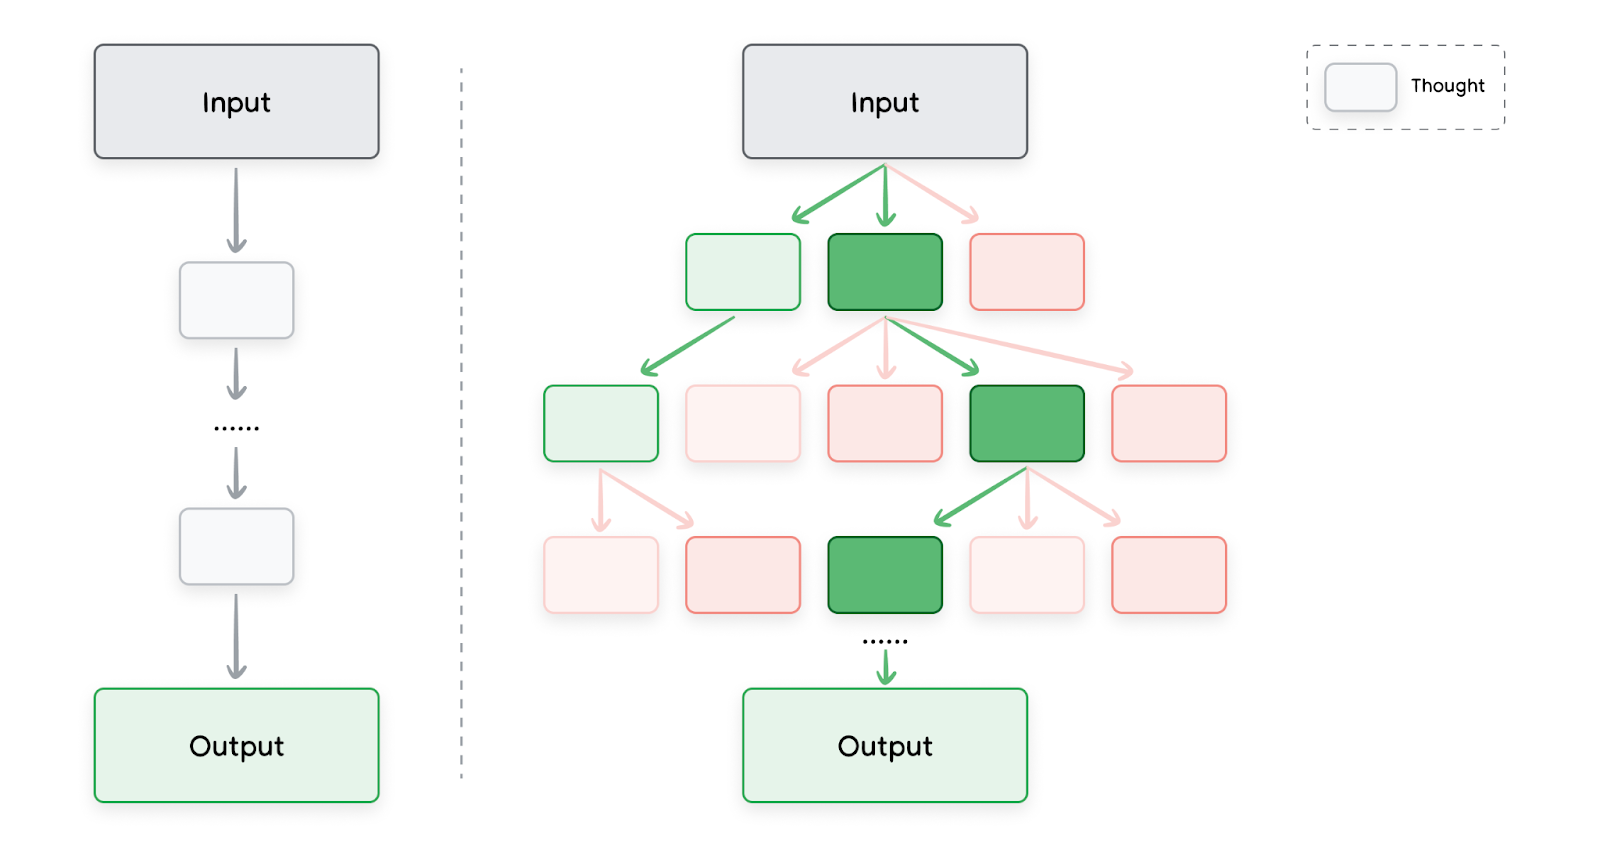
图 1. 思维链提示(左)与思维树提示(右)的可视化对比
这种方法使 ToT 特别适合需要探索的复杂任务。它的工作原理是维护一棵思维树,其中每个思维代表一个连贯的语言序列,作为解决问题过程中的中间步骤。然后,模型可以通过从树的不同节点分支来探索不同的推理路径。
有一个很棒的 notebook,更详细地展示了思维树(ToT),它基于论文《Large Language Model Guided Tree-of-Thought》12。
ReAct(推理与行动)
推理与行动(Reason and Act,ReAct)[10][^13]提示是一种范式,使 LLM 能够使用自然语言推理与外部工具(搜索、代码解释器等)相结合来解决复杂任务,允许 LLM 执行某些操作,例如与外部 API 交互以检索信息,这是迈向智能体(agent)建模的第一步。
ReAct 模仿人类在现实世界中的运作方式,因为我们用语言推理,并通过行动获取信息。ReAct 在各种领域都表现优于其他提示工程方法。
ReAct 提示的工作原理是将推理和行动结合成一个“思考-行动”循环。LLM 首先推理问题并生成行动计划。然后执行计划中的行动并观察结果。随后 LLM 利用观察结果更新推理并生成新的行动计划。这个过程一直持续到 LLM 找到问题的解决方案。
要看到它的实际效果,你需要编写一些代码。在代码片段 1 中,我使用了 Python 的 langchain 框架,以及 VertexAI(google-cloud-aiplatform)和 google-search-results pip 包。
要运行这个示例,你必须从 https://serpapi.com/manage-api-key 创建一个(免费的)SerpAPI 密钥,并设置环境变量 SERPAPI_API_KEY。
接下来,让我们编写一些 Python 代码,任务是让 LLM 弄清楚:有多少孩子有一位在 Metallica 乐队表演的著名父亲。
from langchain.agents import load_tools
from langchain.agents import initialize_agent
from langchain.agents import AgentType
from langchain.llms import VertexAI

prompt = "How many kids do the band members of Metallica have?"
llm = VertexAI(temperature=0.1)
tools = load_tools(["serpapi"], llm=llm)
agent = initialize_agent(tools, llm,
                         agent=AgentType.ZERO_SHOT_REACT_DESCRIPTION, verbose=True)
agent.run(prompt)
代码片段 1. 使用 LangChain 和 VertexAI 创建 ReAct 智能体
代码片段 2 显示了结果。注意 ReAct 进行了一系列五次搜索。事实上,LLM 在抓取 Google 搜索结果来弄清楚乐队成员名字。然后,它将结果列为观察结果,并为下一次搜索链接思考。
> Entering new AgentExecutor chain...
Metallica has 4 members.
Action: Search
Action Input: How many kids does James Hetfield have?
Observation: three children
Thought: 1/4 Metallica band members have 3 children
Action: Search
Action Input: How many kids does Lars Ulrich have?
Observation: 3
Thought: 2/4 Metallica band members have 6 children
Action: Search
Action Input: How many kids does Kirk Hammett have?
Observation: Hammett has been married to his second wife Lani since 1998.
They have two sons, Angel (b. September 29, 2006) and Vincenzo (b. June
28, 2008).
Thought: 3/4 Metallica band members have 8 children
Action: Search
Action Input: How many kids does Robert Trujillo have?
Observation: 2
Thought: 4/4 Metallica band members have 10 children
Final Answer: 10
代码片段 2. 在终端中执行 ReAct 智能体
代码片段 2 弄清楚了 Metallica 乐队有四名成员。然后它逐个搜索每个成员,询问孩子总数并相加。最后,它返回孩子总数作为最终答案。
ReAct 提示在实践中要求你理解必须不断地重新发送之前的提示/响应(并修剪多余生成的内容),以及用适当的示例/指令设置模型。请参考 GoogleCloudPlatform GitHub 仓库中托管的 notebook13,其中更详细地展示了实际的 LLM 输入和输出,并附带更详尽的示例。
自动提示工程
此时你可能意识到编写提示词可能很复杂。如果能自动化这个过程(写一个提示词来写提示词)岂不是很棒?嗯,有一种方法:自动提示工程(Automatic Prompt Engineering,APE)。这种方法14不仅减轻了人工输入的需要,还提高了模型在各种任务中的性能。
你提示一个模型生成更多提示词。评估它们,可能修改其中好的那些。然后重复。
例如,你可以使用自动提示工程来帮助训练一个乐队周边 T 恤网店的聊天机器人。我们想找出客户订购乐队周边 T 恤时可能使用的各种说法。
- 编写将生成输出变体的提示词。在这个例子中,我使用 gemini-pro 生成 10 条指令。见表 15:
| Prompt | 我们有一家乐队周边T恤的网店,为了训练聊天机器人,我们需要各种下单方式,比如:“来一件Metallica小号T恤”。生成10个变体,保持相同的语义,但意思不变。 |
|---|---|
| Output | 我想买一件小号 Metallica T 恤。 我能订购一件小号 Metallica T 恤吗? 我想买一件小号 Metallica T 恤。 一件 Metallica T 恤,小号,谢谢。 我想要一件小号 Metallica T 恤。 我想下订单买一件小号 Metallica T 恤。 小号 Metallica T 恤,一件,谢谢。 我在找一件小号 Metallica T 恤。 你能给我拿一件小号 Metallica T 恤吗? 一件 Metallica 小号 T 恤,谢谢。 |
表 15. 使用 LLM 生成提示词
- 通过根据所选指标对候选提示词评分来评估所有候选指令。例如,你可以使用 BLEU(Bilingual Evaluation Understudy,双语评估替补)或 ROUGE(Recall-Oriented Understudy for Gisting Evaluation,面向摘要评估的召回替补)。
- 选择评估分数最高的候选指令。该候选就是你可以用于软件应用或聊天机器人的最终提示词。你也可以调整选中的提示词并再次评估。
代码提示
Gemini 主要专注于基于文本的提示词,其中也包括编写用于返回代码的提示词。让我们前往 Vertex AI Studio 测试这些提示词,看一些编码示例。
编写代码的提示词
Gemini 也可以充当开发人员,帮助你用你选择的任何编程语言编写代码。作为开发人员,这可以帮助你加快编写代码的过程。
想象一下,你的机器上有一个包含数百个需要重命名的文件的文件夹。逐个重命名每个文件会花费你很多时间。你懂一点 Bash,可以编写一个脚本来自动化这个过程,但这可能也要花一些时间。所以让我们写一个提示词。你可以在面向公众的消费级聊天机器人 Gemini 中写提示词,或者如果你更关心机密性,可以在你的 Google Cloud 账户中打开 Vertex AI Studio 编写这些提示词。Vertex AI Studio 的优势在于你可以配置温度等。
| Name | 1_bash_rename_files_in_folder |
|---|---|
| Goal | 编写一个提示词,让 Bash 编写代码来重命名文件夹中的文件。 |
| Model | gemini-pro |
| Temperature | 0.1 |
| Token Limit | 1024 |
| Top-K | N/A |
| Top-P | 1 |
| Prompt | 写一个 Bash 代码片段,要求输入一个文件夹名称。然后它会获取该文件夹的内容,并通过在文件名前加上 draft 来重命名里面的所有文件。 |
| Output | #!/bin/bash# 问一下文件夹名字 echo "Enter the folder name: "read folder_name# 检查文件夹是否存在 if [ ! -d "$folder_name" ]; then echo "Folder does not exist."exit 1fi# 获取文件夹中的文件列表 files=( "$folder_name"/* )# 通过在文件名前加上“draft”来重命名每个文件 for file in "${files[@]}"; do new_file_name="draft_$(basename "$file")"mv "$file" "$new_file_name"doneecho "Files renamed successfully." |
表 16. 使用 Gemini 编写代码
在我看来这是不错的代码——甚至有注释!然而,由于 LLM 无法推理,会重复训练数据,因此必须先阅读并测试你的代码。
我们期待已久的时刻到了,它真的能工作吗?
让我们先用一个只有几个文件的测试文件夹来尝试,这些文件需要从 filename.txt 重命名为 draft_filename.txt。
- 复制表 16 的输出(不带
bash文本包装),粘贴到一个名为“rename_files.sh”的新文件中。 - 打开终端窗口,输入:
. rename_files.sh。它会要求输入文件夹名称,例如 test,然后按回车。 - 脚本似乎运行正常。你会看到消息:Files renamed successfully。
查看测试文件夹,注意所有文件都被完美重命名为 draft_filename.txt。
它成功了!
解释代码的提示词
作为开发人员,当你在团队中工作时,你必须阅读别人的代码。Gemini 也可以在这方面帮助你。让我们取表 16 中的代码输出,删除注释,让大语言模型解释正在发生的事情,见表 17:
| Name | 1_bash_explain_the_code |
|---|---|
| Goal | 编写一个提示词来解释 Bash 代码 |
| Model | gemini-pro |
| Temperature | 0.1 |
| Token Limit | 1024 |
| Top-K | N/A |
| Top-P | 1 |
| Prompt | 给我解释一下下面的 Bash 代码:#!/bin/bashecho "Enter the folder name: "read folder_nameif [ ! -d "$folder_name" ]; then echo "Folder does not exist."exit 1fifiles=( "$folder_name"/* )for file in "${files[@]}"; do new_file_name="draft_$(basename "$file")"mv "$file" "$new_file_name"doneecho "Files renamed successfully." |
| Output | 这个 Bash 脚本执行以下任务: 1. 用户输入: - 它使用 echo 和 read 命令提示用户输入文件夹名称。输入的文件夹名称存储在 folder_name 变量中。2. 文件夹存在性检查: - 它使用 [ ! -d "$folder_name" ] 条件检查指定名称的文件夹是否存在。如果文件夹不存在,它会显示错误消息(“Folder does not exist.”)并以退出码 1 退出脚本。3. 文件列表: - 它使用 files=( "$folder_name"/* ) 命令列出指定文件夹中的所有文件。这会创建一个名为 files 的数组,包含文件夹中所有文件的路径。4. 文件重命名: - 它使用 for 循环遍历 files 数组中的每个文件。- 对于每个文件,它使用 new_file_name="draft_$(basename "$file")" 命令生成一个新文件名。这个新文件名是通过在原始文件名前加上字符串“draft_”创建的。- 然后它使用 mv "$file" "$new_file_name" 命令重命名文件,将文件移动到新文件名。5. 成功消息: - 重命名所有文件后,它显示一条成功消息(“Files renamed successfully.”),表示重命名操作成功。 |
表 17. 用于解释代码的提示词
翻译代码的提示词
表 16 中的 Bash 代码似乎运行良好。然而,如果它能提示我输入文件名,这个脚本才能真正可复用,理想情况下它应该作为一个带 UI 的独立应用程序运行。作为起点,对于(Web)应用程序来说,Python 是比 Bash 更好的语言。LLM 可以帮助将代码从一种语言翻译成另一种语言。见表 18 中的示例:
| Name | 1_python_rename_files |
|---|---|
| Goal | 编写一个提示词,将 Bash 代码翻译为 Python |
| Model | gemini-pro |
| Temperature | 0.1 |
| Token Limit | 1024 |
| Top-K | N/A |
| Top-P | 1 |
| Prompt | 把下面的 Bash 代码翻译成 Python 代码片段。#!/bin/bashecho "Enter the folder name: "read folder_nameif [ ! -d "$folder_name" ]; then echo "Folder does not exist."exit 1fifiles=( "$folder_name"/* )for file in "${files[@]}"; do new_file_name="draft_$(basename "$file")"mv "$file" "$new_file_name"doneecho "Files renamed successfully." |
| Output | import osimport shutil# 从用户那里获取文件夹名称 folder_name = input("Enter the folder name: ")# 检查文件夹是否存在 if not os.path.isdir(folder_name):print("Folder does not exist.")exit(1)# 获取文件夹中所有文件的列表 files = os.listdir(folder_name)# 遍历文件 for file in files:# 创建一个以“draft_”为前缀的新文件名 new_file_name = f"draft_{file}"# 把文件改名移动 shutil.move(os.path.join(folder_name, file), os.path.join(folder_name, new_file_name))# 打印成功消息 print("Files renamed successfully.") |
表 18. 将代码从 Bash 翻译为 Python 的提示词
阅读并检查代码。复制提示词的输出,粘贴到一个新文件中:file_renamer.py。打开终端窗口,执行以下命令 python file_renamer.py 来测试代码。
注意: 在 Vertex AI 的 Language Studio 中提示(Python)代码时,你必须点击“Markdown”按钮。否则你会收到纯文本,缺少正确的行缩进,而缩进对运行 Python 代码很重要。
调试和审查代码的提示词
让我们手动对表 18 的代码做一些修改。它应该提示用户输入文件名前缀,并将此前缀写成大写字符。见代码片段 3 中的示例代码,但太糟糕了。它现在返回 Python 错误!
import os
import shutil

folder_name = input("Enter the folder name: ")
prefix = input("Enter the string to prepend to the filename: ")

text = toUpperCase(prefix)

if not os.path.isdir(folder_name):
    print("Folder does not exist.")
    exit(1)

files = os.listdir(folder_name)

for file in files:
    new_filename = f"{text}_{file}"
    shutil.move(os.path.join(folder_name, file),
                os.path.join(folder_name, new_file_name))

print("Files renamed successfully.")
代码片段 3. 一个有 bug 的 Python 脚本
哎呀!看起来有个 bug:
The below Python code gives an error:
Traceback (most recent call last):
  File "/Users/leeboonstra/Documents/test_folder/rename_files.py", line 7,
in <module>
    text = toUpperCase(prefix)
NameError: name 'toUpperCase' is not defined
代码片段 4. 我弄坏了 Python 代码
让我们看看能否让大语言模型调试和审查代码。请看表 19:
| Name | 1_python_debug_code |
|---|---|
| Goal | 编写一个提示词来调试和审查 Python 代码。 |
| Model | gemini-pro |
| Temperature | 0.1 |
| Token Limit | 1024 |
| Top-K | N/A |
| Top-P | 1 |
| Prompt | 下面的 Python 代码会报错:Traceback (most recent call last):File "/Users/leeboonstra/Documents/test_folder/rename_files.py", line 7, in <module> text = toUpperCase(prefix)NameError: name 'toUpperCase' is not defined调试一下哪里有问题,并解释我该如何改进代码。 import osimport shutil# 从用户那里获取文件夹名称folder_name = input("Enter the folder name: ")prefix = input("Enter the string to prepend to the filename: ")text = toUpperCase(prefix)# 检查文件夹是否存在if not os.path.isdir(folder_name):print("Folder does not exist.")exit(1)# 获取文件夹中所有文件的列表files = os.listdir(folder_name)# 遍历文件for file in files:# 创建一个带有前缀 "draft_" 的新文件名 new_filename = f"{text}_" ...new_filename = f"{text}_{file}"# 把文件改名移动 shutil.move(os.path.join(folder_name, file),os.path.join(folder_name, new_file_name))# 打印成功消息 print("Files renamed successfully.") |
| Output | 代码调用 toUpperCase 函数将 prefix 转换为大写,但该函数未定义。要解决这个问题,你可以使用字符串类的 upper() 方法,它将给定字符串转换为大写。修改后的代码如下所示:import osimport shutil# 从用户那里获取文件夹名称 folder_name = input("Enter the folder name: ")prefix = input("Enter the string to prepend to the filename: ")text = prefix.upper()# 检查文件夹是否存在 if not os.path.isdir(folder_name):print("Folder does not exist.")exit(1)# 获取文件夹中所有文件的列表files = os.listdir(folder_name)# 遍历文件 for file in files:# 创建一个带有前缀 "draft_" 的新文件名 new_filename = f"{text}_{file}"# 把文件改名移动 shutil.move(os.path.join(folder_name, file),os.path.join(folder_name, new_filename))# 打印成功消息 print("Files renamed successfully.") |
表 19. 用于调试和审查 Python 代码的提示词
此外,还可以对代码做几项其他改进:
- 新文件名的扩展名没有保留。最好从原始文件名中提取扩展名并附加到新文件名。
- 代码假设文件夹名称中没有空格。然而,正确处理空格是一个好做法,可以用下划线或连字符替换它们。
- 使用
f字符串语法进行字符串插值比传统的+运算符更易读、更简洁。 - 代码没有处理重命名过程中可能发生的错误。最好将
shutil.move调用包装在try...except块中,以捕获任何潜在错误。
以下是应用了这些建议的改进代码:
import os
import shutil

# Get the folder name from the user
folder_name = input("Enter the folder name: ")
prefix = input("Enter the string to prepend to the filename: ")

# Check if the folder exists
if not os.path.isdir(folder_name):
    print("Folder does not exist.")
    exit(1)

# Get a list of all files in the folder
files = os.listdir(folder_name)

# Iterate over the files
for file in files:
    # Get the file extension
    ext = os.path.splitext(file)[1]
    # Create a new file name with the prefix and the file extension
    new_filename = f"{prefix}_{os.path.splitext(file)[0]}{ext}"
    # Build the full paths for the original and new files
    old_path = os.path.join(folder_name, file)
    new_path = os.path.join(folder_name, new_filename)
    # Try to move the file
    try:
        shutil.move(old_path, new_path)
    except Exception as e:
        print(f"An error occurred while moving the file {file}: {e}")

# Print a success message
print("Files renamed successfully.")
这些改进使代码更健壮、更灵活,同时也更容易阅读和理解……(响应被截断,因为它已达到 token 上限。如果需要更长的响应,请尝试增加 token 上限。)
太棒了。它不仅告诉我如何解决问题,还发现我的代码有更多 bug 以及如何解决它们。提示词的最后一部分给出了总体上改进代码的建议。
多模态提示
提示代码仍然使用相同的常规大语言模型。多模态提示是一个独立的问题,它指的是一种使用多种输入格式来引导大语言模型的技巧,而不是仅仅依赖文本。根据模型的能力和手头的任务,这可以包括文本、图像、音频、代码甚至其他格式的组合。
最佳实践
找到正确的提示词需要反复调试。Vertex AI 中的 Language Studio 是试验提示词的绝佳场所,能够针对各种模型进行测试。
使用以下最佳实践成为提示工程专家。
提供示例
最重要的最佳实践是在提示词中提供(单样本/少样本)示例。这非常有效,因为它是一种强大的教学工具。这些示例展示了期望的输出或类似的响应,让模型从中学习,并相应地调整自己的生成。这就像给模型一个参考点或目标,提高其响应的准确性、风格和语气,以更好地匹配你的期望。
设计要简洁
提示词应该简洁、清晰,对你和模型都易于理解。经验法则是,如果它对你来说已经令人困惑,对模型来说可能也同样令人困惑。尽量不要使用复杂的语言,不要提供不必要的信息。
示例:
修改前:
我现在正在纽约,我想了解更多关于好去处的信息。我和两个3岁的孩子在一起。我们度假期间应该去哪儿?
修改后:
作为旅游向导,为游客介绍。在纽约曼哈顿带着三岁小孩时,值得游玩的好地方。
尝试使用描述动作的动词。这里有一组示例:
Act(执行)、Analyze(分析)、Categorize(归类)、Classify(分类)、Contrast(对比)、Compare(比较)、Create(创建)、Describe(描述)、Define(定义)、Evaluate(评估)、Extract(提取)、Find(查找)、Generate(生成)、Identify(识别)、List(列出)、Measure(测量)、Organize(整理)、Parse(解析)、Pick(挑选)、Predict(预测)、Provide(提供)、Rank(排序)、Recommend(推荐)、Return(返回)、Retrieve(检索)、Rewrite(重写)、Select(选择)、Show(展示)、Sort(分类)、Summarize(总结)、Translate(翻译)、Write(编写)。
明确说明输出要求
要明确期望的输出。简洁的指令可能不足以引导 LLM,或者可能过于笼统。在提示词中提供具体细节(通过系统或上下文提示)可以帮助模型专注于相关内容,提高整体准确性。
示例:
要这样做(DO):
撰写一篇关于前五大电子游戏主机的三段式博客文章。博客文章应具有信息性和吸引力,并且应以对话式风格编写。
不要这样做(DO NOT):
写一篇关于电子游戏主机的博客文章。
多用指令,少用约束
指令和约束都用于引导 LLM 的输出。
- 指令(instruction) 对响应的期望格式、风格或内容提供明确指示。它引导模型应该做什么或产生什么。
- 约束(constraint) 是对响应的一系列限制或边界。它限制模型不应该做什么或避免什么。
越来越多的研究表明,在提示中侧重正面指令可能比过度依赖约束更有效。这种方法符合人类偏好正面指令而非“不要做什么”清单的倾向。
指令直接传达期望的结果,而约束可能让模型猜测什么是允许的。指令在定义好的边界内提供灵活性并鼓励创造力,而约束可能限制模型的潜力。此外,一长串约束还可能会相互冲突。
约束仍然有价值,但只在某些情况下:防止模型生成有害或有偏见的内容,或者需要严格的输出格式或风格时。
如果可能,使用正面指令:与其告诉模型不要做什么,不如告诉它应该做什么。这可以避免混淆并提高输出的准确性。
要这样做(DO):
写一篇关于前五大电子游戏主机的单段博客文章。只讨论主机、制造公司、年份和总销量。
不要这样做(DO NOT):
写一篇关于前五大游戏主机的博客文章,一段即可,但不要列出具体的游戏名称。
作为最佳实践,优先考虑指令,明确说明你希望模型做什么,只在安全、清晰或特定要求需要时才使用约束。试验并迭代,测试指令和约束的不同组合,以找到最适合你特定任务的方案,并记录下来。
控制最大 token 长度
要控制 LLM 生成响应的长度,你可以在配置中设置最大 token 限制,或者在提示词中明确要求特定长度。例如:
“用一条推文的长度解释量子物理学。”
在提示词中使用变量
为了复用提示词并使其更具动态性,可以在提示词中使用变量,这些变量可以根据不同输入进行更改。例如,如表 20 所示,一个提供城市事实的提示词。不要硬编码城市名称,而是使用变量。变量可以节省你的时间和精力,避免重复。如果你需要在多个提示词中使用同一段信息,可以将其存储在变量中,然后在每个提示词中引用该变量。这在将提示词集成到你自己的应用时非常有意义。
| Prompt | 变量 {city} = "阿姆斯特丹" 提示 你是一个旅行指南。告诉我关于这座城市的一个事实:{city} |
|---|---|
| Output | 阿姆斯特丹是一座美丽的城市,到处都是运河、桥梁和狭窄的街道。它丰富的历史、文化和夜生活使其成为绝佳的旅游目的地。 |
表 20. 在提示词中使用变量
试验输入格式和写作风格
不同的模型、模型配置、提示格式、措辞和提交方式可能产生不同的结果。因此,试验提示词的属性(如风格、措辞和提示类型(零样本、少样本、系统提示))非常重要。
例如,一个以生成关于革命性游戏主机世嘉 Dreamcast 的文本为目标的提示词,可以被表述为问题、陈述或指令,从而产生不同的输出:
- 问题: 什么是世嘉 Dreamcast,为什么它是如此革命性的主机?
- 陈述: 世嘉 Dreamcast 是世嘉于 1999 年发布的第六代视频游戏主机。它……
- 指令: 写一段描述世嘉 Dreamcast 主机并解释它为什么如此革命性的文字。
少样本分类任务要打乱类别顺序
一般来说,少样本示例的顺序关系不大。然而,在做分类任务时,确保在少样本示例中打乱可能的响应类别。这是因为否则你可能过度拟合示例的特定顺序。通过打乱可能的响应类别,你可以确保模型学习识别每个类别的关键特征,而不是简单地记忆示例的顺序。这将带来对未见数据更稳健、更具泛化性的性能。
一个好的经验法则是从 6 个少样本示例开始,并从此处开始测试准确率。
适应模型更新
密切关注模型架构变化、新增数据和能力非常重要。尝试更新的模型版本,并调整你的提示词以更好地利用新模型特性。Vertex AI Studio 等工具非常适合存储、测试和记录提示词的各种版本。
试验输出格式
除了提示词输入格式,还可以考虑试验输出格式。对于提取、选择、解析、排序、排名或分类数据等非创造性任务,尝试让输出以 JSON 或 XML 等结构化格式返回。
从提取数据的提示词中返回 JSON 对象有一些好处。在真实世界的应用中,我不需要手动创建这种 JSON 格式,我已经可以按排序顺序返回数据(在处理 datetime 对象时非常方便),但最重要的是,通过提示词要求 JSON 格式,可以迫使模型创建结构并限制幻觉。
少样本提示部分中的表 4 显示了如何返回结构化输出的示例。
与其他提示工程师一起试验
如果你处于必须尝试提出一个好的提示词的情况,你可能想找多个人一起尝试。当每个人都遵循最佳实践(如本章所列)时,你会看到不同提示尝试之间的性能差异。
CoT 最佳实践
对于 CoT 提示,必须在推理之后放置答案,因为推理的生成会改变模型在预测最终答案时得到的标记。
使用 CoT 和自我一致性时,你需要能够从提示中提取最终答案,并将其与推理部分分开。
对于 CoT 提示,将温度设置为 0。
思维链提示基于贪心解码,即根据语言模型分配的最高概率预测序列中的下一个词。一般来说,当使用推理得出最终答案时,很可能只有一个正确答案。因此,温度应始终设置为 0。
记录各种提示尝试
最后一条建议在前面已经提到过,但无论怎么强调都不为过:详细记录你的提示尝试,这样你才能随着时间了解哪些有效、哪些无效。
提示输出可能因模型、采样设置而异,甚至因同一模型的不同版本而异。此外,即使对同一模型使用完全相同的提示,输出句子的格式和措辞也可能出现微小差异。(例如,如前所述,如果两个标记具有相同的预测概率,平局可能会随机打破。这随后会影响后续预测的标记。)
我们建议创建一个 Google Sheet,以表 21 为模板。这种方法的好处是,当你不可避免地需要重新审视你的提示工作时,你拥有一份完整记录——无论是为了将来重新拾起(你会惊讶于短暂休息后你能忘记多少)、在不同版本的模型上测试提示性能,还是帮助调试未来的错误。
除了此表中的字段外,跟踪提示词的版本(迭代)也很有帮助,还需要一个字段记录结果是否为“正常/不正常/有时正常”,以及一个记录反馈的字段。如果你有幸使用 Vertex AI Studio,请保存你的提示词(使用与文档中相同的名称和版本),并在表中跟踪已保存提示词的超链接。这样,你随时只需点击一次即可重新运行提示词。
在处理检索增强生成(RAG)系统时,你还应该记录 RAG 系统中影响插入提示词内容的具体方面,包括查询、分块设置、分块输出和其他信息。
一旦你觉得提示词接近完美,就把它带到你的项目代码库中。在代码库中,将提示词与代码分开保存在单独的文件中,这样更容易维护。最后,理想情况下你的提示词应该是可操作化系统的一部分,作为提示工程师,你应该依靠自动化测试和评估流程来了解你的提示词在任务上的泛化程度。
提示工程是一个迭代过程。编写并测试不同的提示词,分析并记录结果。根据模型的表现改进你的提示词。不断试验,直到获得期望的输出。当你更换模型或模型配置时,回到之前使用的提示词并继续试验。
| Name | [提示词的名称和版本] |
|---|---|
| Goal | [用一句话解释这次尝试的目标] |
| Model | [所用模型的名称和版本] |
| Temperature | [0 - 1 之间的值] |
| Token Limit | [数字] |
| Top-K | [数字] |
| Top-P | [数字] |
| Prompt | [写下完整的提示词] |
| Output | [写出输出或多个输出] |
表 21. 记录提示词的模板
总结
本白皮书讨论了提示工程。我们学习了各种提示技巧,例如:
- 零样本提示
- 少样本提示
- 系统提示
- 角色提示
- 上下文提示
- 退一步思考提示
- 思维链
- 自我一致性
- 思维树
- ReAct
我们甚至还研究了如何自动化你的提示词。
白皮书随后讨论了生成式 AI 的挑战,例如提示词不足时可能出现的问题。最后,我们以如何成为更好的提示工程师的最佳实践作为结尾。
尾注
-
Google, 2023, Gemini by Google. 网址:https://gemini.google.com.
↩ -
Google, 2024, Gemini for Google Workspace Prompt Guide. 网址:https://inthecloud.withgoogle.com/gemini-for-google-workspace-prompt-guide/dl-cd.html.
↩ -
Google Cloud, 2023, Introduction to Prompting. 网址:https://cloud.google.com/vertex-ai/generative-ai/docs/learn/prompts/introduction-prompt-design.
↩ -
Google Cloud, 2023, Text Model Request Body: Top-P & top-K sampling methods. 网址:https://cloud.google.com/vertex-ai/docs/generative-ai/model-reference/text#request_body.
↩ -
Wei, J., et al., 2023, Zero Shot - Fine Tuned language models are zero shot learners. 网址:https://arxiv.org/pdf/2109.01652.pdf.
↩ -
Google Cloud, 2023, Google Cloud Model Garden. 网址:https://cloud.google.com/model-garden.
↩ -
Brown, T., et al., 2023, Few Shot - Language Models are Few Shot learners. 网址:https://arxiv.org/pdf/2005.14165.pdf.
↩ -
Zheng, L., et al., 2023, Take a Step Back: Evoking Reasoning via Abstraction in Large Language Models. 网址:https://openreview.net/pdf?id=3bq3jsvcQ1
↩ -
Google Cloud Platform, 2023, Chain of Thought and React. 网址:https://github.com/GoogleCloudPlatform/generative-ai/blob/main/language/prompts/examples/chain_of_thought_react.ipynb.
↩ -
Wang, X., et al., 2023, Self Consistency Improves Chain of Thought reasoning in language models. 网址:https://arxiv.org/pdf/2203.11171.pdf.
↩ -
Yao, S., et al., 2023, Tree of Thoughts: Deliberate Problem Solving with Large Language Models. 网址:https://arxiv.org/pdf/2305.10601.pdf.
↩ -
Wei, J., et al., 2023, Chain of Thought Prompting. 网址:https://arxiv.org/pdf/2201.11903.pdf.
↩ ↩ -
Google Cloud Platform, 2023, Advance Prompting: Chain of Thought and React. 网址:https://github.com/GoogleCloudPlatform/applied-ai-engineering-samples/blob/main/genai-on-vertex-ai/advanced_prompting_training/cot_react.ipynb.
↩ -
Zhou, C., et al., 2023, Automatic Prompt Engineering - Large Language Models are Human-Level Prompt Engineers. 网址:https://arxiv.org/pdf/2211.01910.pdf.
↩